HavacılıkBölüm 45 / 86
Rezervasyon profillerinin kümelenmesi ve iptal oranı analizi
Tek tek uçuşların rezervasyon profilleri tahmine doğrudan girecek kadar sağlam değil; k-means ile standart profillere indirgeniyor ya da hiyerarşik seviyelerde saklanıyor. Bu bölüm iki yolun neden farklı kabul gördüğünü ve profil ailesinin en istikrarlı üyesi olan iptal oranı profilinin nasıl hesaplandığını, aşırı satış kararına neden en güvenilir girdi olduğunu anlatıyor.
Havacılık · İçindekiler
- Kökler
- 01Posta sözleşmesinden SABRE'ye
- 02SABRE'den PSS'e: bir mimari neden 60 yıl yaşadı
- 031978: kâr garantisi kalkınca gelir yönetimi doğdu
- Gelir yönetimi
- 04Yield Management: erken dönem stratejik analiz ve iş mantığı
- 05Yield Management: rekabet stratejileri ve PEOPLExpress analizi
- 06Gelir yönetimi ve stratejik operasyonlar: PEOPLExpress ve American Airlines analizi
- 07PEOPLExpress ve havacılık sektörü: sadakat programları ve dağıtım sistemleri stratejik analizi
- Dağıtım
- 08Havacılık rezervasyon ve küresel dağıtım sistemleri (GDS) analizi: stratejik gelişim ve iş mantığı
- 09Havacılık endüstri standartları ve yönetişim: stratejik analiz belgesi
- 10GDS ve havacılık dağıtım ekosistemi: stratejik analiz ve iş mantığı rehberi
- 11Havacılık rezervasyon sistemleri ve dijital dağıtım kanalları stratejik analizi
- Perakendecilik
- 12Seyahat değer zinciri ve dağıtım kanalları analizi: stratejik brifing notu
- 13Seyahat dağıtım ekosistemi ve yeni dağıtım yeteneği (NDC) analizi
- 14NDC@Scale: havacılık dağıtım kanallarında dönüşüm ve iş mantığı analizi
- Operasyon
- 15Havayolu pazarlama planlama süreci ve iş mantığı analizi
- 16Havacılık planlaması ve gelir yönetimi: stratejik analiz
- 17Havacılıkta gelir yönetimi ve rekabet stratejileri: Sun Tzu prensipleriyle iş mantığı analizi
- Ücret ve fiyatlama
- 18Havayolu fiyatlandırma ve verim yönetimi stratejileri: analitik bir bakış
- 19Havacılık fiyatlandırma ürünleri ve iş mantığı analizi
- 20Havacılık ücret ürünlerinin sınıflandırılması: stratejik analiz ve iş mantığı
- 21Havacılık dağıtım kanalları ve ücret kuralları: stratejik analiz belgesi
- 22Havacılık ücret kuralları ve yolculuk tipleri stratejik analizi
- 23Havacılık güzergah fiyatlandırması ve iş mantığı analizi
- 24Ücret yapılandırması, segmentasyon ve sadakat programları analizi
- 25Havacılıkta özel ücretler ve fiyat esnekliği
- 26Havacılıkta ücret yönetimi ve planlama stratejileri
- 27Reaktif fiyatlandırma süreci ve stratejik karar mekanizmaları
- 28Proaktif fiyatlandırma ve ücret rasyonalizasyonu: stratejik iş mantığı analizi
- 29Havacılıkta gelir paylaşımı: çok taraflı ve ikili prorate anlaşmaları (MPA ve SPA)
- 30Havayolu ek hizmetleri (ancillaries) ve iş mantığı analizi
- 31Havacılık gelir yönetimi ve ücret yapıları analizi
- Talep tahmini
- 32Havacılıkta spill (taşan talep) modeli ve iş mantığı analizi
- 33Beklenen kapasite aşımı (expected spill) ve Boeing modeli analizi
- 34Havacılık talep tahmini ve spill (taşan talep) modelleri analizi
- 35Gelir yönetiminde beklenen kayıp (spill) ve talep analizi
- 36Havacılık spill modelleri için girdi parametrelerinin kalibrasyonu
- 37Havacılıkta kapasite yönetimi ve spill (taşan talep) analizi
- 38Nominal doluluk oranı ve talep kaybı (spill) analizi
- 39Yüksek varyanslı talep ve iki aşamalı Cox dağılımı
- 40İki aşamalı Cox dağılımıyla spill ölçümü
- 41Havacılık endüstrisi ve gelir yönetimi analizi
- 42Havacılık gelir yönetimi alternatifleri ve iş mantığı analizi
- 43Gelir artışı ve tahmin doğruluğu: iki boyutlu zamanda talep tahmini
- 44Rezervasyon profilleri ve talep tahmini
- 45Rezervasyon profillerinin kümelenmesi ve iptal oranı analizi
- 46Gelir yönetiminde talep profilleri ve veri arındırma
- 47Gelir yönetiminde talep tahmini ve kısıtlanmamış talep analizi
- 48Havacılık talebi tahminleme ve zaman serisi analizi
- 49Gelir yönetiminde tahminleme modelleri ve iş mantığı analizi
- 50Havacılık gelir yönetimi: rezervasyon tahminleme ve talep analizi
- 51O&D talep tahmini: birinci ve ikinci nesil yaklaşımlar
- 52Rekabetçi havayolu alışveriş verileri analizi
- 53Havacılıkta veri odaklı iş mantığı ve karar destek sistemleri
- 54Havacılık gelir yönetimi ve tüketici tercih modellemesi
- 55İtinerer tercih modelleri ve talep analizi
- 56O&D tahminleme ve must-forecast listesi
- Envanter ve erişilebilirlik
- 57Havacılık ve hizmet sektöründe overbooking stratejileri ve operasyonel analiz
- 58Biniş oranı tahmini ve overbooking stratejileri
- 59Havacılıkta overbooking (fazla rezervasyon) ve show-up modelleme stratejileri
- 60Havacılıkta overbooking stratejileri ve gelir yönetimi
- 61İndirim tahsis kontrolleri, Littlewood kuralı ve Gamma talep modeli
- 62Gamma dağılımı ve indirim tahsisi: koruma seviyeleri ve gelir oranları
- 63İndirim tahsisi ve rezervasyon optimizasyonu: EMSR ve entegre overbooking
- 64Rezervasyon envanter kontrolü ve gelir yönetimi
- 65Karma ve hibrit envanter kontrol sistemleri
- 66Havacılık gelir yönetimi: envanter kontrolü ve iş mantığı analizi
- 67Paylaşımlı kabin envanteri ve funnel uçuşlar
- 68Havacılık gelir yönetimi performans ölçümü
- 69Gelir fırsat modeli (ROM) ve havayolu gelir yönetimi performansının ölçümü
- 70Gelir yönetiminde kritik durum belirleme ve O&D stratejileri
- 71Havayolu envanter kontrol stratejileri ve ağ etkileri
- 72Havacılık gelir yönetimi: virtual nesting (sanal yuvalama) analizi
- 73Sanal gruplama ve çift indeksleme: havacılık envanterinde koltuğun kime açılacağı
- 74Dinamik sanal gruplama (dynamic virtual nesting) ve gelir yönetimi analizi
- 75Havacılık gelir yönetimi ve O&D optimizasyonu: sanal yuvalama ve CER
- 76Sürekli yuvalama (continuous nesting) ve teklif fiyatı kontrol sistemleri analizi
- 77Havacılık gelir yönetimi: şebeke optimizasyon modelleri
- 78Gelir yönetiminde ağ optimizasyonu ve bacak ayrıştırma
- 79Havacılık gelir yönetimi ve ağ optimizasyonu stratejileri
- 80O&D gelir yönetimi ve koltuk kullanılabilirliği hesaplama
- 81Yolcu değerlemesinde ücret kalifikasyon kuralları
- 82Havacılık gelir yönetimi ve envanter kontrol sistemleri: post-process nesting analizi
- Teklif ve teşhir
- 83Markalı ücret aileleri ve bağlantı mimarisi
- 84Havacılık envanter yönetimi ve GDS entegrasyon sistemleri
- 85Havacılık envanter kontrolü ve O&D yönetimi
- 86Havacılık rezervasyon ve envanter yönetimi: stratejik iş mantığı analizi
Rezervasyon profili, bir uçuşun kalkıştan önceki okuma günlerinde ne hızla dolduğunu gösteren eğri. Önceki bölüm bu eğrinin nasıl kurulduğunu, satışa kapalı dönemlerin nasıl ayıklandığını anlattı. Bu bölüm bir sonraki soruyu soruyor: kurulan binlerce eğriden hangisine, ne kadar güvenilir? Cevap iki katmanlı. Rezervasyon profilleri tek başına oynak; ya kümelenip standart profillere indirgeniyor ya da hiyerarşik seviyelerde birleştiriliyor. Ama profil ailesinin bir üyesi bu düzeltmelere pek ihtiyaç duymuyor. Gelir yönetiminde en güvenilir profil, kaç yolcunun geleceğini değil, gelmiş olanların kaçının gideceğini söyleyen iptal oranı profili.
Tek bir uçuşun profili tahmine girecek kadar sağlam değil
Kaynak metin sorunu kısa koyuyor: bireysel profiller oynak olma eğiliminde. İki sebebi var. Birincisi tarihsel gözlem yetersizliği; belirli bir uçuş, belirli bir sınıf ve belirli bir haftanın günü için geriye dönük çok az örnek birikiyor. İkincisi, profili tarafsızlaştırırken satışa kapalı zaman aralıklarının dışarıda bırakılması. Önceki bölümde anlatılan arındırma doğru bir işlem, ama bedeli var: kapalı dönemi çıkarılan profil, zaten az olan veriyi daha da inceltiyor.
Hacim sorunu da aynı yere çıkıyor. Profil sayısını uçuş ayağı ya da segment, rezervasyon sınıfı ve haftanın günü belirliyor; bu üçü çarpılıyor. Sunumdaki örnekte günde 100 uçuş, 10 sınıf ve 7 gün, 7.000 ayrı profil ediyor. Bu kadar eğriyi tek tek izlemek analist için imkânsız, tek tek güvenmek de istatistik için yanlış.
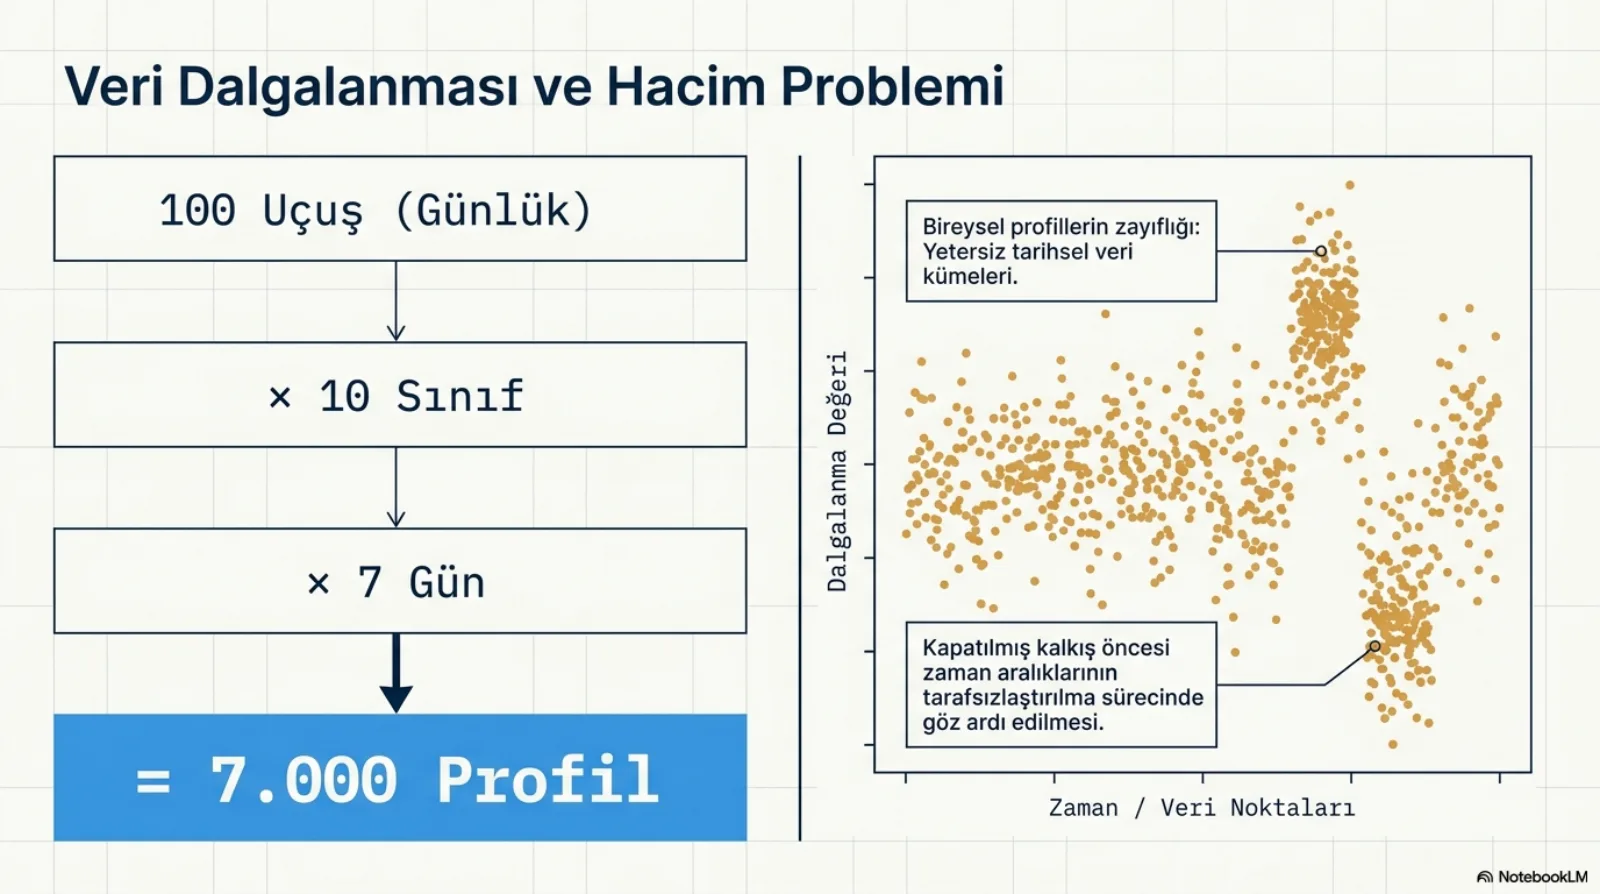
Yazılım tarafında bunun karşılığı tanıdık: kardinalitesi çarpımla büyüyen bir anahtar uzayında her hücrenin kendi istatistiğini tutmak, hücre başına örnek sayısını sıfıra yaklaştırır. Tahmin motoruna giden şey artık sinyal değil, gürültü. Çözüm, benzer davranan hücreleri birleştirip daha az ama daha dolu gruplar kurmak.
K-means hızlı ama sonucu başladığı yere bağlı
Birleştirmenin ilk yolu standart profiller: benzer rezervasyon akışı gösteren bireysel profilleri kümeleyip her kümeyi tek bir temsilci eğriyle ifade etmek. Sunum burada k-means algoritmasını anıyor (Anderberg, 1973). Algoritma merkez tabanlı (centroid-based) çalışıyor: her kümenin bir merkezi var, her profilin o merkeze uzaklığı hesaplanıyor ve profiller adım adım yeniden eşlenerek küme içi hata karelerinin toplamı azaltılıyor. Uzaklığın en büyük olduğu, yani kümeye en kötü oturan profiller önce yer değiştiriyor.
Döngünün ilk adımı normalizasyon, ve bu atlanabilecek bir hazırlık değil. Bir yoğun hat sınıfı yüzlerce rezervasyonla, bir tali hat sınıfı birkaç rezervasyonla profil üretiyor. Ham sayılarla çalışan bir uzaklık ölçüsü eğrinin şeklini değil büyüklüğünü kümeler; büyük uçuşlar kendi aralarında, küçükler kendi aralarında toplanır. Normalize edilmiş profiller ise farklı ölçekteki uçuşları aynı şekle göre yan yana koyuyor. Kaynak metnin çıkarımı bu yüzden kesin: k-means öncesinde veri mutlaka normalize edilmeli.
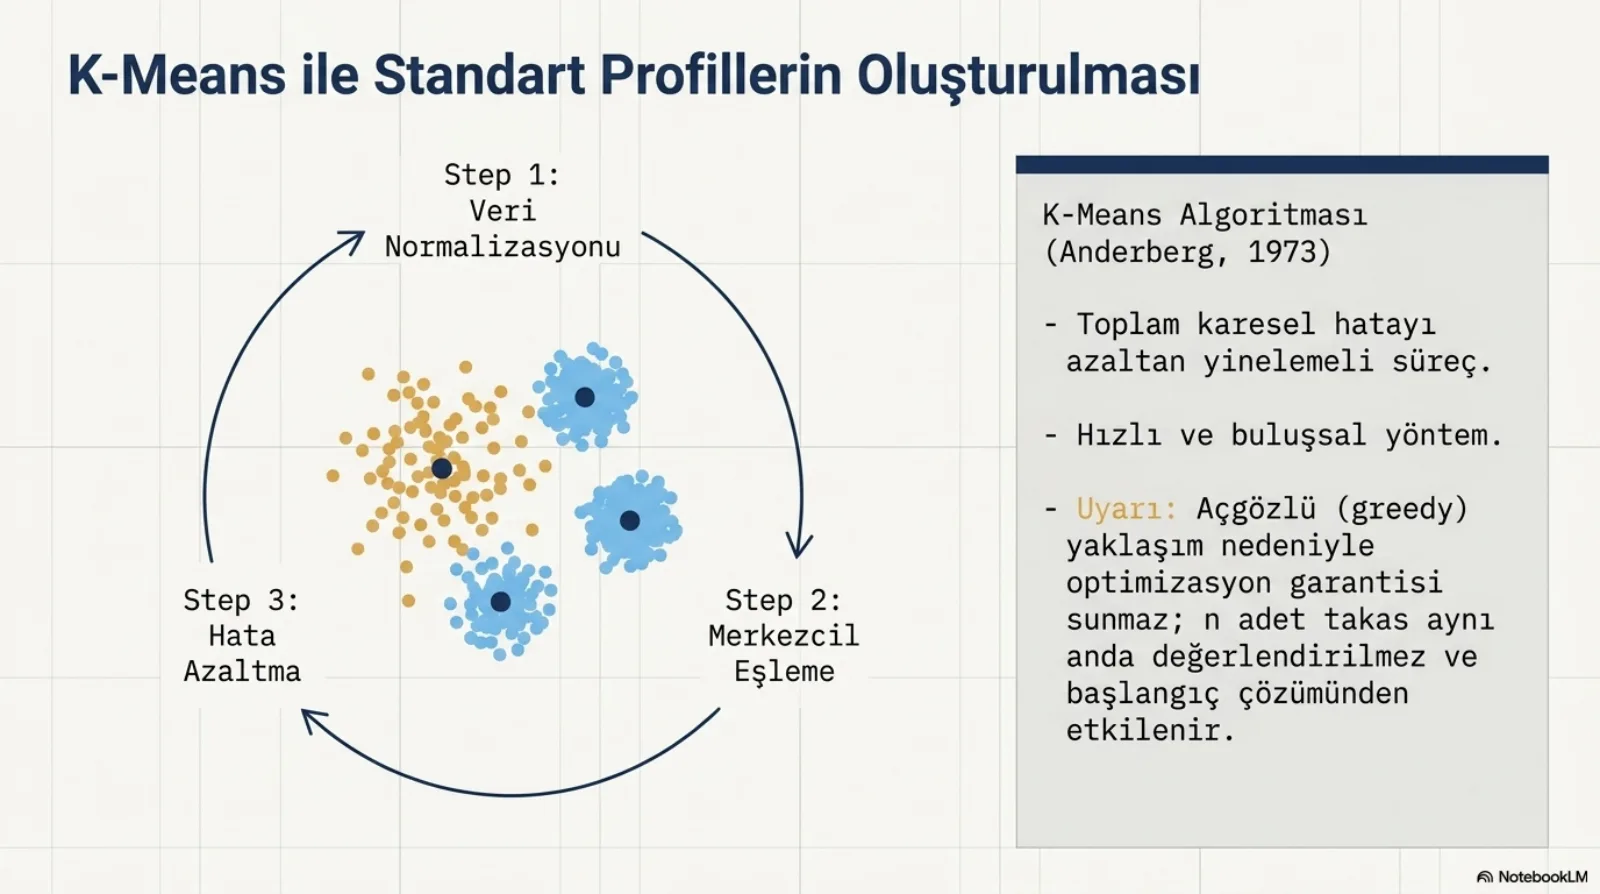
Kaynak metin algoritmanın sınırını da açık söylüyor: k-means açgözlü bir yaklaşım ve optimalliği garanti etmiyor. Yer değiştirmeleri eşzamanlı değerlendirmiyor, tek tek yapıyor. Her adım o an en iyi görüneni seçtiği için ulaşılan kümeleme büyük ölçüde başlangıç çözümüne ve tanımlanan iterasyon sınırına bağlı. Durdurma kriteri de iş mantığının parçası: toplam hata karesi için önceden belirlenmiş bir eşik ya da sabit bir iterasyon sayısı. Eşiğe ulaşıldığında hesaplama hızı ile doğruluk arasındaki denge gözetilerek işlem kesiliyor.
Buna rağmen tercih ediliyor, çünkü hızlı. Kombinatoryal doğasına karşın diğer kümeleme algoritmalarına göre oldukça çabuk sonuç veriyor. Büyük veri setine sahip bir havayolu için yeterince iyi bir kümelemeyi hızla almak, mutlak optimuma yavaşça ulaşmaktan daha değerli olabiliyor.
Mühendislik tarafında bunun iki pratik sonucu var. Başlangıca duyarlı bir algoritmanın çıktısı, başlangıç sabitlenmeden tekrar üretilemez; aynı veriyle iki gece çalışan iş iki farklı standart profil seti verebilir ve analist bunu talepte bir değişiklik sanabilir. Durdurma eşiği ve iterasyon sınırı da kodun içine gömülü sabitler olmamalı; hız ile doğruluk arasındaki dengeyi iş birimi ayarlıyor, o ayar görünür ve değiştirilebilir durmalı.
Analist, ortalamaya değil kendi uçuşuna güveniyor
Kümelemenin zayıf noktası tam da gücünden geliyor. Standart profil bir ortalama; belirli bir uçuşun gerçek rezervasyon akışından sapan genel bir sonuç üretebiliyor. O sapma bazen gürültü, bazen de o uçuşa özgü gerçek bir davranış. Kümeleme ikisini ayırt etmiyor.
Kaynak metin burada istatistikle insan arasındaki farka dikkat çekiyor: hiyerarşik yaklaşım, verim yönetimi analistlerinden genellikle daha geniş kabul görüyor. Hiyerarşik yapıda tarafsızlaştırılmış gerçek veri birkaç seviyede saklanıyor: uçuş ayağı (leg), uçuş segmenti, pazar, pazar varlığı (market entity) ve sistem geneli. Analist bir uçuşun kendi verisine bakabiliyor, veri inceyse bir üst seviyeye çıkıp pazarın ya da sistemin davranışıyla karşılaştırabiliyor. Makro ve mikro okuma aynı yapıda duruyor.
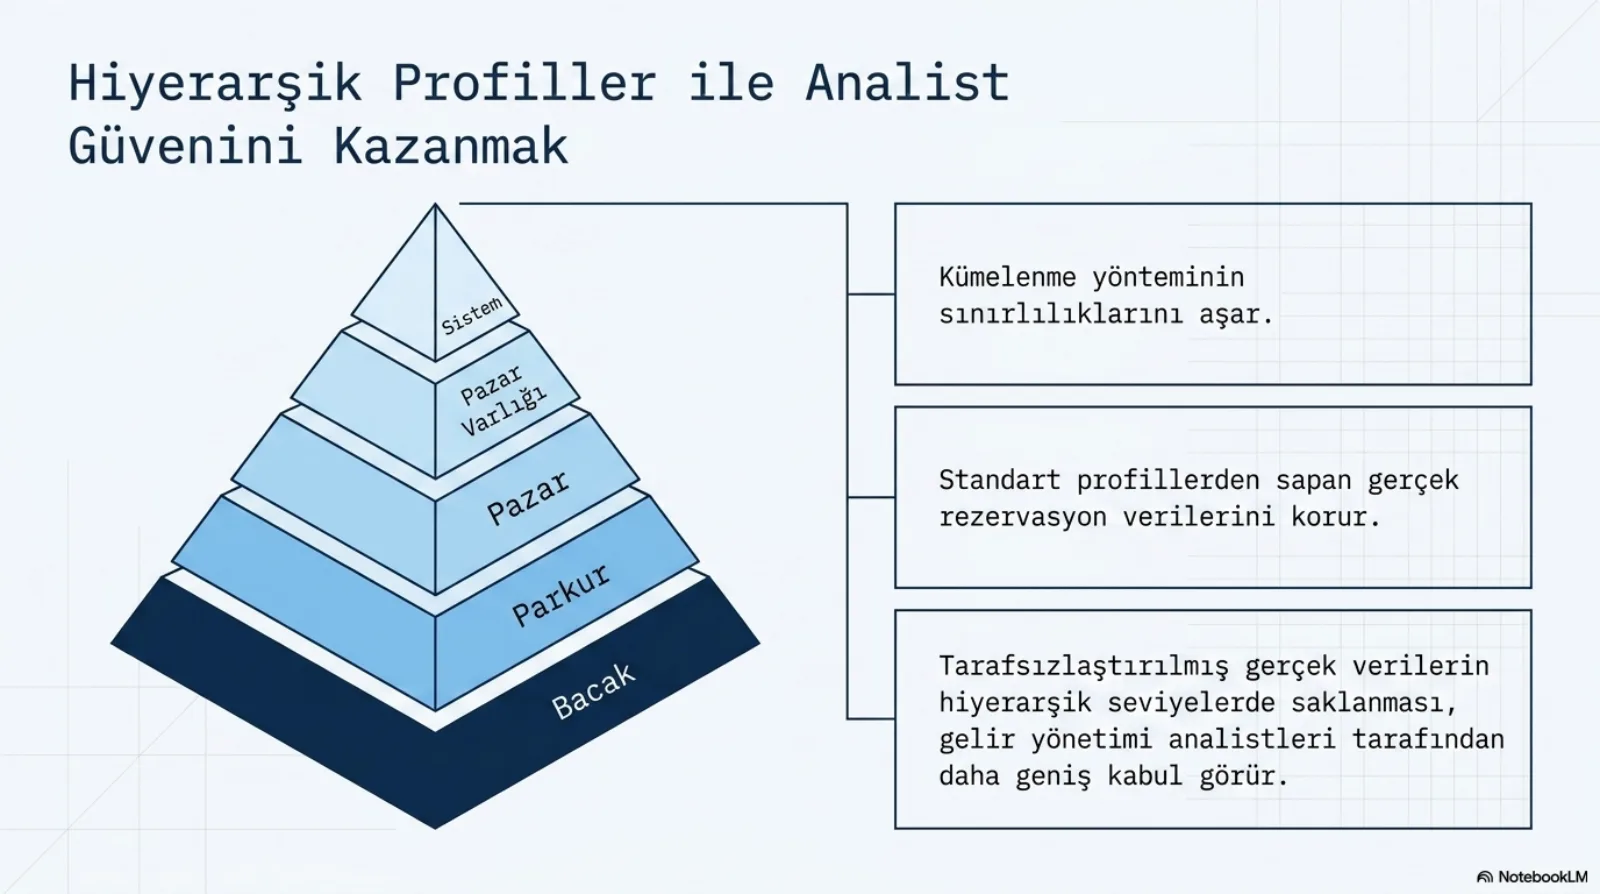
İki yaklaşımın farkı bir karşılaştırma tablosunda netleşiyor. Standart profil veriyi standartlaştırıyor ve bunu yaparken gerçek sapmaları silebiliyor; hiyerarşik profil gerçek ve tarafsız veriyi olduğu gibi koruyor. Kümeleme hesaplama açısından hızlı ama optimum garantisi yok; hiyerarşi ise depolama açısından daha yoğun. Analist kabulünde sonuç ters: kümelemede sınırlı, hiyerarşide geniş.
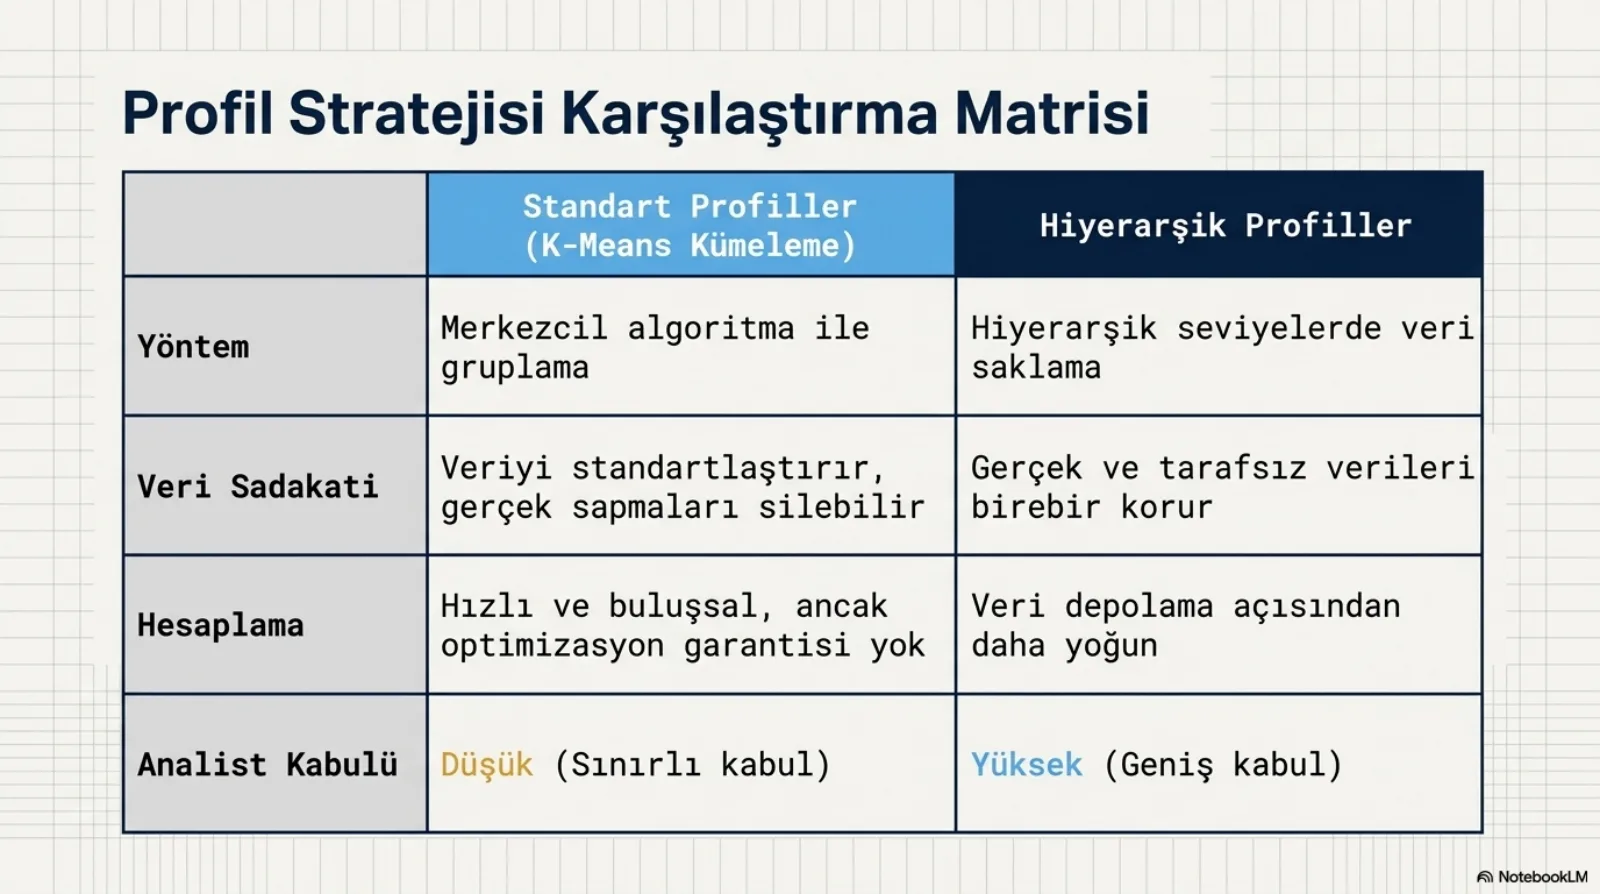
Bu, sistem tasarımında göz ardı edilen bir gereksinim. Otomatik kümeleme sonucunu tek girdi olarak sunan bir gelir yönetimi sistemi, analistin itiraz edemediği bir kara kutu üretiyor. Kaynak metnin önerisi, otomatik sonuçlara tek başına güvenmemek ve analistin kontrolüne izin veren hiyerarşik veri yapılarını (pazar, segment seviyesi) sisteme baştan eklemek. Yazılım karşılığı, aynı ham veriden beş seviyede toplanmış görünüm tutmak ve her tahminin hangi seviyeden beslendiğini gösterebilmek. Depolama maliyeti burada bilinçli olarak ödenen bir bedel.
İptal oranı, profil ailesinin istikrarlı üyesi
Buraya kadar anlatılan her şey, rezervasyon profilinin oynaklığıyla başa çıkmanın yollarıydı. İptal oranı profili bu yolların hiçbirine o kadar muhtaç değil. Kaynak metin bunu yapısal bir özellik olarak tanımlıyor: iptal oranı profilleri doğası gereği yüksek istikrar gösteriyor ve bu yüzden yaygın olarak kullanılıyor.
Hesap bir oran. Belirli bir okuma gününde eldeki rezervasyonlardan kalkıştan önce iptal edilenlerin sayısı, o okuma günündeki toplam rezervasyon sayısına bölünüyor. Kaynak metin sonucu şöyle tanımlıyor: iptal oranı eldeki rezervasyonların bir yüzdesi olarak ifade ediliyor. Yani profil okuma günü başına tek bir soruyu cevaplıyor: bugün elimde duran rezervasyonların yüzde kaçı uçağa binmeden düşecek?
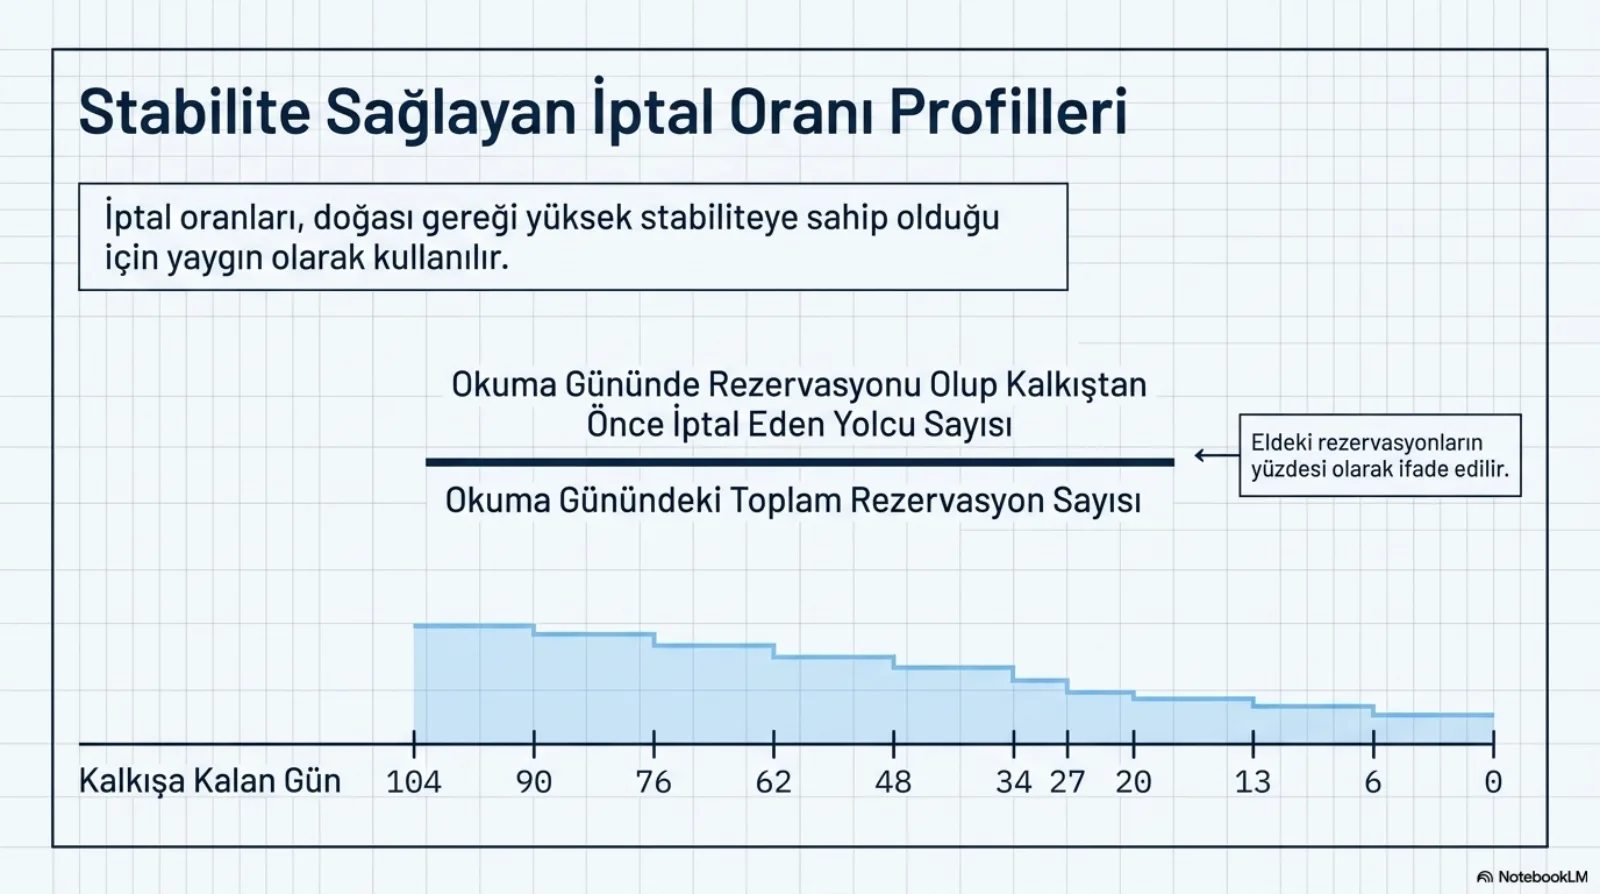
Tanımın iki ayrıntısı önemli. Birincisi payda: oran, o güne kadar alınmış bütün rezervasyonlara değil, o okuma gününde elde duranlara göre kuruluyor. Böylece profilin her noktası kendi başına kullanılabiliyor; 48. günde elinde belli sayıda rezervasyon olan bir analist, o günün oranını çarparak kalkışa kadar kaç tanesini kaybedeceğini öngörebiliyor. İkincisi eksen: sunumdaki eğri 104. günden başlayıp 90, 76, 62, 48, 34, 27, 20, 13 ve 6. günlerden geçerek kalkışa iniyor. Okuma günleri kalkışa yaklaştıkça sıklaşıyor, ve eğri her basamakta biraz daha alçalıyor. Kalkışa ne kadar az zaman kaldıysa, elde duran rezervasyonun iptal edilmek için o kadar az fırsatı kalıyor.
Rezervasyon profilinden farkı da burada. Rezervasyon profili bir akışı ölçüyor: iki okuma günü arasında kaç yeni rezervasyon geldi. Bu akış satışa açıklığa, fiyata, rakibin hamlesine bağlı; sınıf kapandığında sıfırlanıyor ve arındırma gerektiriyor. İptal oranı ise elde duran stoğun bir oranı; yeni satışı değil, zaten alınmış rezervasyonun davranışını ölçüyor. Kaynak metin istikrarın sebebini ayrıntılandırmıyor, ama tanımdaki bu fark kümelemeye ve hiyerarşiye başvurulan oynaklık sorununun iptal tarafında neden aynı şiddette konuşulmadığını açıklamaya yetiyor.
Operasyonel sonucu doğrudan. Kalkışa kalan gün sayısına göre elde duran rezervasyonların yüzde kaçının kaybedileceğini bilmek, kapasiteyi o kayba göre yönetmek demek. Kaynak metnin çıkarımı da bu yönde: iptal oranlarının tarihsel istikrarı, aşırı satış (overbooking) stratejisi kurulurken en güvenilir veri noktalarından biri olarak kullanılmalı. Aşırı satış, iptal edecek yolcunun koltuğunu önceden satmak; ne kadar satılacağı da o yolcunun oranına ne kadar güvenildiğine bağlı.
Yazılım tarafında bunun karşılığı veri modelinde başlıyor. Oranı hazır yüzde olarak saklayan bir tablo, farklı uçuşları ya da seviyeleri birleştirirken yanlış sonuç verir; yüzdelerin ortalaması, toplamların oranı değil. Pay ve paydayı okuma günü başına ayrı tutmak, hiyerarşinin her seviyesinde oranı doğru yeniden hesaplamanın tek yolu. İkinci karşılık zaman ekseninde: iptal profili, rezervasyon profiliyle aynı okuma günü takvimini kullanıyor. İki profilin gün ekseni ayrı ayrı tanımlanırsa, tahmin motoru aynı günün iki farklı okumasını yan yana koyar.
Üç profil tek bir tahmine akıyor
Sunumun son slaytı parçaları bir boru hattında birleştiriyor. Bireysel rezervasyon verisi iki kola ayrılıyor: k-means ile kurulan standart profiller ve hiyerarşik profiller. Rezervasyon iptal oranları üçüncü kol olarak ayrıca geliyor. Üçü bir optimizasyon motorunda buluşuyor ve çıktı temel ücret gelir tahmini. Bireysel rezervasyon dalgalanmaları ve iptal eğilimleri, uçuş gelirini maksimize eden tahmin profillerine dönüştürülüyor.
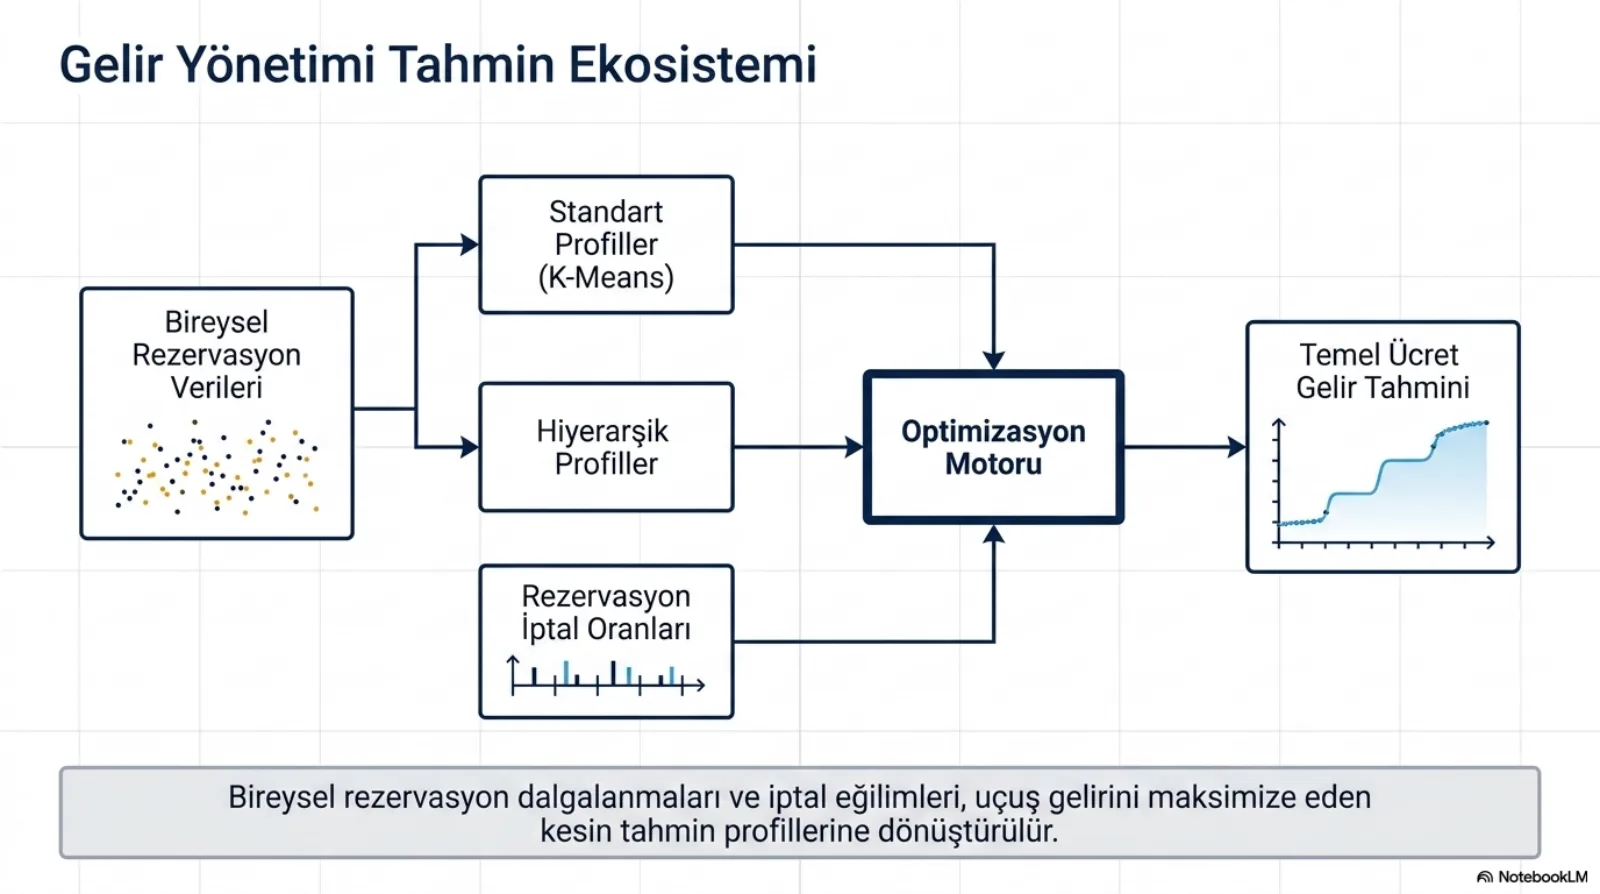
Diyagramdaki ayrım kasıtlı okunmaya değer. Rezervasyon verisi motora ancak bir düzeltmeden, kümeleme ya da hiyerarşiden geçtikten sonra giriyor. İptal oranı ise doğrudan giriyor. Motorun iki girdisi var ve biri ötekinden çok daha az işlem istiyor. Bir tahmin sisteminin kalitesini iyileştirmek isteyen ekip, emeğini önce hangi girdinin oynak olduğuna göre dağıtmalı.
Yarın işe yarayacak dört çıkarım
- K-means’ten önce normalize et, başlangıcı sabitle. Normalize edilmemiş profiller şekle göre değil büyüklüğe göre kümelenir. Algoritma açgözlü ve başlangıca duyarlı olduğu için başlangıç çözümünü, durdurma eşiğini ve iterasyon sınırını kayıt altına al; aksi halde iki çalıştırma arasındaki farkı talep değişimi sanırsın.
- Hızı mutlak optimuma tercih etmeyi bilinçli seç. Büyük veri setlerinde yeterince iyi kümelemeyi hızla almak çoğu zaman daha değerli. Ama bu bir tercih; hata eşiğini iş birimine görünür ve ayarlanabilir bırak.
- Kümelemenin yanına hiyerarşi koy. Tarafsızlaştırılmış veriyi bacak, segment, pazar, pazar varlığı ve sistem seviyelerinde sakla; analistin standart profilden sapan uçuşu kendi verisiyle görebilmesini sağla. Depolama maliyeti, analistin sisteme güvenmesinin bedeli.
- Aşırı satışı iptal profiline dayandır, pay ve paydayı ayrı tut. İptal oranı eldeki rezervasyonun yüzdesi ve yapısal olarak istikrarlı; aşırı satış kararının en güvenilir girdilerinden biri. Oranı hazır yüzde olarak değil, okuma günü başına iptal sayısı ve eldeki rezervasyon sayısı olarak sakla ki her seviyede doğru toplanabilsin.
Bu bölümde ne yok: rezervasyon profilinin okuma günleriyle nasıl kurulduğu ve satışa kapalı dönemlerin nasıl arındırıldığı (rezervasyon profillerini anlatan önceki bölüm), satışa kapanan uçuşun göremediği talebin nasıl hesaplandığı (spill bölümleri) ve aşırı satış seviyesinin kendisinin nasıl optimize edildiği. Bu bölüm, tahmin motoruna giden profillerin hangisinin ne kadar işlenmesi gerektiğini anlatmak için var.